

Поиск и безопасное удаление контента
Публичный API чтения выдаёт опубликованный контент. Его списки не заменяют полноценный механизм запросов, но в нём есть маршрут поиска по актуальным данным GET /v1/_search и маршрут подсказок при вводе GET /v1/_search/suggest. Управляемые и генерируемые сайты строят по нему свои страницы поиска. С сервера, при сборке и из Worker API читается без настройки CORS. Для браузерного приложения на другом источнике разрешите его в разделе Настройки → API → Источники браузерных запросов. См. настройку источников. Не помещайте черновики и приватный контент в публичный индекс без аутентификации.
Включите поиск по сайту
Заголовок раздела «Включите поиск по сайту»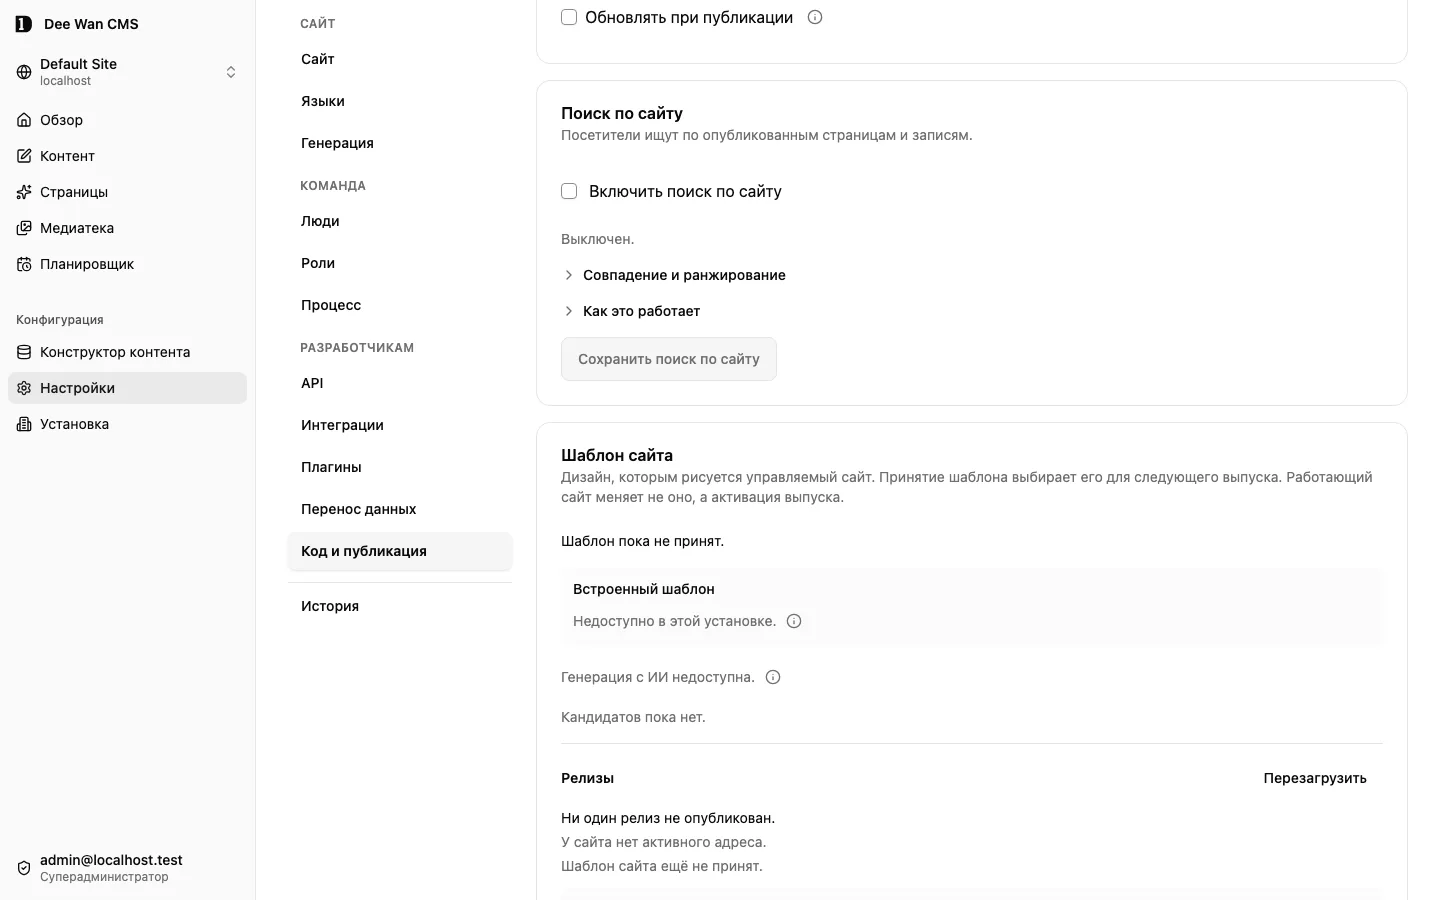
Откройте Настройки → Код и публикация → Поиск по сайту. Нужно право site:infra. Отметьте Включить поиск по сайту и сохраните.
Поиск всегда охватывает опубликованные страницы, а на сайте-блоге — опубликованные записи. В разделе Искать также отметьте другие публичные типы контента, до 16. Приватный тип контента никогда не предлагается и не ищется.
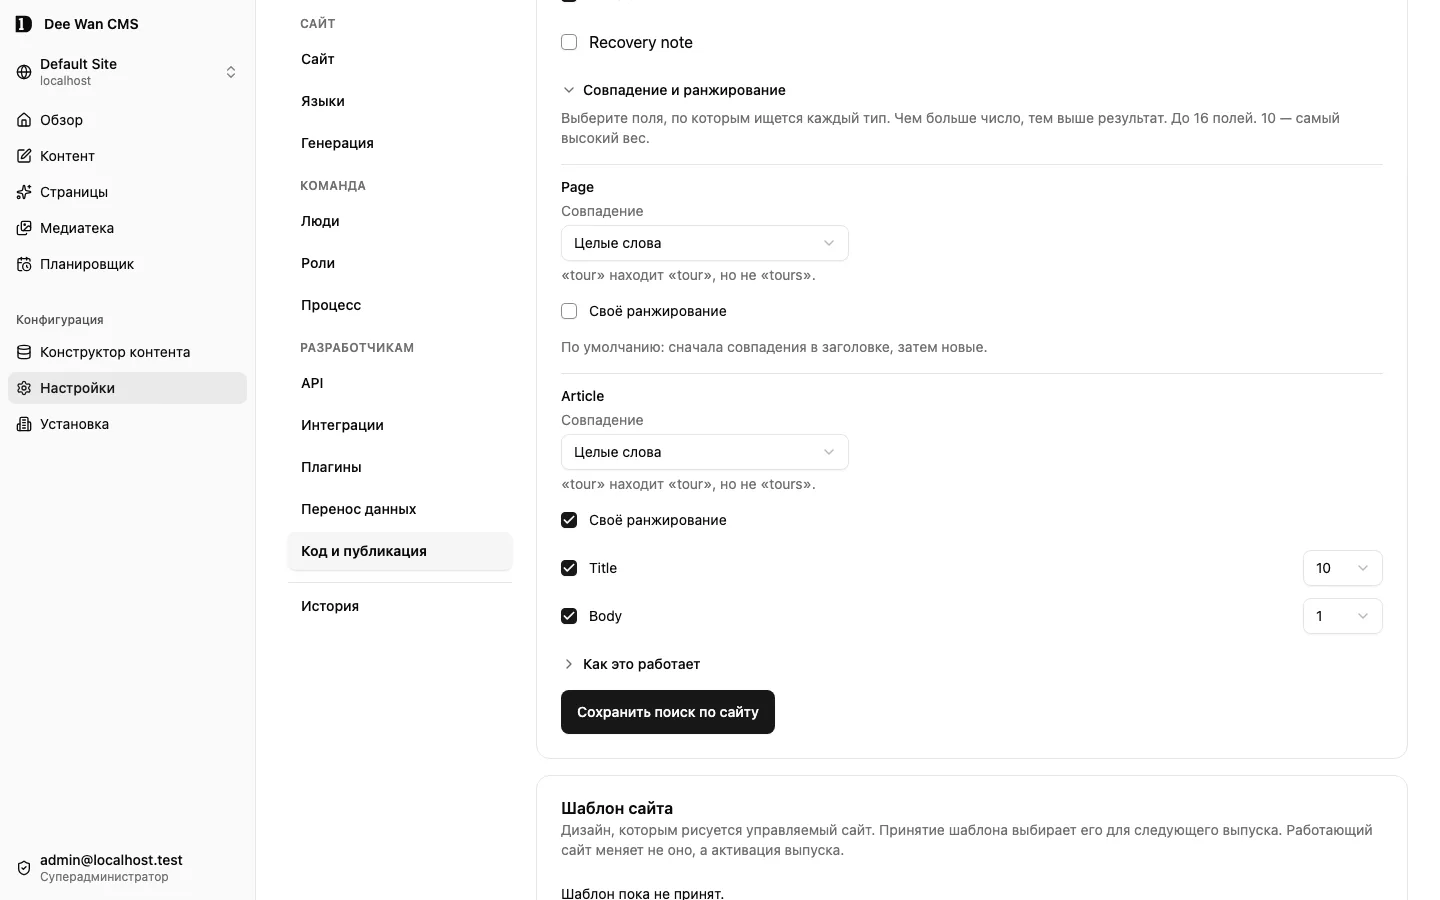
Настройте ранжирование
Заголовок раздела «Настройте ранжирование»По умолчанию сначала идёт результат, в заголовке которого есть все слова, затем самые новые. Чтобы изменить это для одного типа контента, откройте Совпадение и ранжирование в разделе Поиск по сайту и отметьте Своё ранжирование для этого типа.
- Выберите до 16 полей для поиска по записям этого типа. По остальным полям поиск для него не выполняется.
- Дайте каждому полю вес от 1 до 10. Позиция результата определяется наибольшим весом среди отмеченных полей, содержащих все слова запроса. 10 — самый высокий вес.
- В новой настройке заголовку задан вес 10, остальным текстовым полям — 1.
- Тип без настройки сохраняет ранжирование по умолчанию. Совпадение в его заголовке считается за 10.
- Снимите отметку с типа, чтобы вернуть настройки по умолчанию.
- Приоритет поиска записи сдвигает её опубликованный результат от −10 до 10. Ноль не меняет ранжирование типа. Приоритет не добавляет запись, которая не совпала с запросом; новое значение начинает действовать после публикации.
Изменение действует со следующего поиска. Ничего не пересобирается, а управляемые и генерируемые сайты ранжируют одинаково. Страница результатов, открытая до изменения, просит начать поиск заново, когда посетитель запрашивает ещё.
Выберите, как совпадают слова
Заголовок раздела «Выберите, как совпадают слова»У каждого типа контента в поиске есть настройка Совпадение в разделе Совпадение и ранжирование. Каждое слово запроса должно соответствовать выбранному правилу поиска.
| Совпадение | Находит | Пример |
|---|---|---|
| Целые слова (по умолчанию) | Только то же слово | «tour» находит «tour», но не «tours» |
| Формы английских слов | Другие формы английского слова | «tour» находит также «tours» и «touring» |
| Части слов | Буквы в любом месте слова | «tour» находит также «tours» и «detour» |
- Слова — это буквы, знаки и цифры. Знаки — это комбинируемые диакритики, а также знаки гласных и тонов в письменностях вроде тайской, поэтому они остаются внутри слова. Всё остальное только разделяет слова: «don’t» — это слова «don» и «t».
- Возьмите слова в двойные кавычки, чтобы искать их подряд и по порядку в одном поле. Незакрытая кавычка или пустая фраза отклоняется; поиск не исправляет такой запрос.
- Режим Формы английских слов работает на любом сайте. Результаты на английском (
en,en-GB,en_USи подобные) ищутся по формам слов, на любом другом языке — по целым словам. Правило определяется языком каждого результата. Поэтому, если поиск на тайском возвращает английскую запись по цепочке fallback, она находится по формам слов, а тайские записи — по целым словам. - В языках без пробелов между словами, например тайском, режим Целые слова ищет целую последовательность букв. Для таких языков выберите Части слов.
- Изменение действует со следующего поиска. Все формы сохраняются вместе с контентом, поэтому ничего не пересобирается, а старый и новый режимы сопоставления не смешиваются в одном ответе. Страница результатов, открытая до изменения, просит начать поиск заново, когда посетитель запрашивает ещё.
Подсветка результатов
Заголовок раздела «Подсветка результатов»Страницы и блоки поиска отмечают совпавшие слова в названии и описании результата. Фраза подсвечивается только там, где слова стоят подряд и по порядку. Части текста сохраняют оригинал, поэтому символы, похожие на разметку, остаются текстом. Ответы поиска и подсказок могут содержать title_parts и summary_parts с полями text и match. Собственный интерфейс может использовать их для подсветки, выводя значение как текст, а не HTML. Старые ответы без этих полей тоже можно показать, только без подсветки.
Приоритет записи меняет только порядок, но не добавляет совпадения.
Связанные записи
Заголовок раздела «Связанные записи»Запись можно найти и по названиям записей, на которые она ссылается через поле связи, например запись по имени автора:
- Связанная запись учитывается, только пока она опубликована, её тип контента публичный и сама запись не в корзине. Учитывается её опубликованное название на том языке, который показывается посетителю. Название из черновика не учитывается никогда. Переименование учитывается после публикации.
- Приватное поле связи, приватное поле названия или приватный тип контента ничего не добавляют.
- Краткое описание результата никогда не показывает названия связанных записей.
Поиск по актуальным данным на управляемом сайте
Заголовок раздела «Поиск по актуальным данным на управляемом сайте»Сайт, который обслуживает управляемый рендерер, ищет то, что опубликовано сейчас. Ничего не пересобирается:
- Публикация сразу появляется в поиске. Снятие языка с публикации, перенос записи в корзину, её удаление и смена адреса тоже действуют сразу.
- Результаты приходят на языке посетителя. При политике fallback запись без этого языка показывается на первом языке своей цепочки.
- Черновики, приватные типы контента и записи с отметкой Скрыть от поисковых систем никогда не появляются.
/searchищет на языке по умолчанию, а/<language>/search— на другом. Поисковые системы эти страницы не индексируют.- Раздел Поиск по сайту на любой странице показывает то же поле поиска и показывает результаты на месте.
Если поиск не может ответить, страница всё равно загружается и сообщает: «Search is not available right now. Try again later.» Сбой поиска никогда не блокирует релиз.
Опубликованная страница с адресом /search или /<language>/search блокирует новый релиз, пока поиск включён. Смените адрес этой страницы или выключите поиск.
Поиск по сайту на генерируемом сайте Dee Wan
Заголовок раздела «Поиск по сайту на генерируемом сайте Dee Wan»Генерируемый сайт ищет по тому же актуальному индексу, что и управляемый, через тот же эндпоинт и то же поле поиска. Чтобы обновить поиск, ничего не пересобирается:
/searchищет на языке по умолчанию, а/<language>/search— на другом. У генерируемого сайта такие страницы есть для языка по умолчанию и для каждого языка, на котором опубликован контент или который использует блог. Язык сайта, на котором ничего не опубликовано, не получает страницу поиска до следующей сборки после публикации. Навигация сайта ссылается на эти страницы. Они рендерятся при каждом запросе, никогда не кэшируются и не индексируются поисковыми системами.- Секция Поиск по сайту переводит страницу в режим отображения при каждом запросе. Результаты показываются на месте. Все поля поиска на одной странице выполняют один общий поиск.
- Публикация страниц и записей блога, снятие языка с публикации, перемещение в корзину, удаление и смена адреса сразу отражаются в поиске. Выбор в разделах Искать также и Совпадение и ранжирование тоже действует.
- Результат поиска ведёт на страницу по адресу, который она получила при этой сборке, а запись блога — на свой адрес в блоге. Страница, опубликованная после последней сборки, или запись другого типа контента показывается без ссылки, пока следующая сборка не назначит ей адрес.
- При выключенном поиске или неизвестном языке ответ — 404. Если поиск не может ответить, страница поиска отвечает 503 и сообщает: «Search is not available right now. Try again later.» Раздел поиска на странице никогда не ломает страницу.
Поиск читает /v1/_search на собственном хосте сайта, поэтому Worker сайта нуждается в global_fetch_strictly_public в apps/site/wrangler.jsonc. У новых сайтов он есть. Существующий файл без него блокирует подготовку и развёртывание сайта с указанием причины.
Проверенные команды генерируемого сайта не меняются:
node scripts/install-dependencies.mjs apps/sitenpm run --prefix apps/site checknpm run --prefix apps/site buildНе запускайте обычный npm install в сгенерированном дереве. Регенерация сохраняет shared-файлы зависимостей. См. расширение бэкенда.
Подсказки при вводе
Заголовок раздела «Подсказки при вводе»Каждое поле поиска на управляемом или генерируемом сайте предлагает совпадения, пока посетитель печатает:
- Подсказки появляются с двух символов и показывают до пяти опубликованных записей: заголовок, краткое описание и ссылку. Слова ищутся по правилу Совпадение, выбранному для типа; последнее слово может быть неполным и совпадает с началом слова (в режиме Части слов — с любой частью слова). Сначала идёт запись, заголовок которой начинается с введённых слов, затем записи, в заголовке которых они есть, затем остальные. Предлагаются только записи, у которых есть адрес на этом сайте. Для типа с собственными настройками поиск идёт только по отмеченным полям.
- Они читают тот же актуальный контент, что и поиск: черновики, приватные типы контента, корзина, неопубликованные языки и записи, скрытые от поисковых систем, никогда не появляются. Публикация или снятие с публикации отражается сразу.
- Перемещайтесь по списку клавишами со стрелками. Enter открывает выделенную запись; если ничего не выделено, выполняется обычный поиск. Escape закрывает список, второй Escape очищает поле. Щелчок или касание открывает запись. Программы чтения с экрана воспринимают список как combobox и сообщают, сколько в нём подсказок.
- Если подсказки не загружаются, список остаётся скрытым, а поле поиска продолжает работать. Без JavaScript поле — обычная форма поиска.
- Ничего из того, что вводят посетители, не сохраняется и не подсчитывается.
Поле обращается к собственному /search?suggest=<words>&locale=<language> сайта, который читает GET /v1/_search/suggest и строит ссылку на каждую запись так же, как на результаты поиска. Политика безопасности управляемого сайта разрешает ровно этот один скрипт, по хешу.
Поиск по актуальным данным для фронтенда, который вы размещаете сами
Заголовок раздела «Поиск по актуальным данным для фронтенда, который вы размещаете сами»Ваш собственный фронтенд может вызывать тот же эндпоинт со своего сервера:
curl "https://example.com/v1/_search?q=lighthouse&locale=en&limit=10"Каждое слово q должно удовлетворять правилу поиска своего типа (см. Выберите, как совпадают слова). Слова фразы в двойных кавычках должны идти подряд и по порядку в одном поле. Вес поля и опубликованный приоритет записи вместе задают её позицию; время публикации разрешает равные позиции. Для следующей страницы того же запроса передайте page.next_cursor как cursor. Курсор, выданный до изменения ранжирования или режима сопоставления, отклоняется с public_search_invalid; начните поиск заново. Результат содержит kind, model, slug и locale, а также может содержать title_parts и summary_parts для безопасной подсветки. Ссылку стройте по своим маршрутам. search_off означает, что поиск на сайте выключен. Все параметры и отказы перечислены в публичном API чтения.
Для подсказок отправьте ровно один q (от 2 до 100 символов), один locale и, при желании, limit (от 1 до 10, по умолчанию 5):
curl "https://example.com/v1/_search/suggest?q=light&locale=en"Слова ищутся по правилам, выбранным для каждого типа, а последнее слово может быть неполным. Ответ содержит query, data, limit и locale; у каждой записи те же поля, что и у результата поиска.
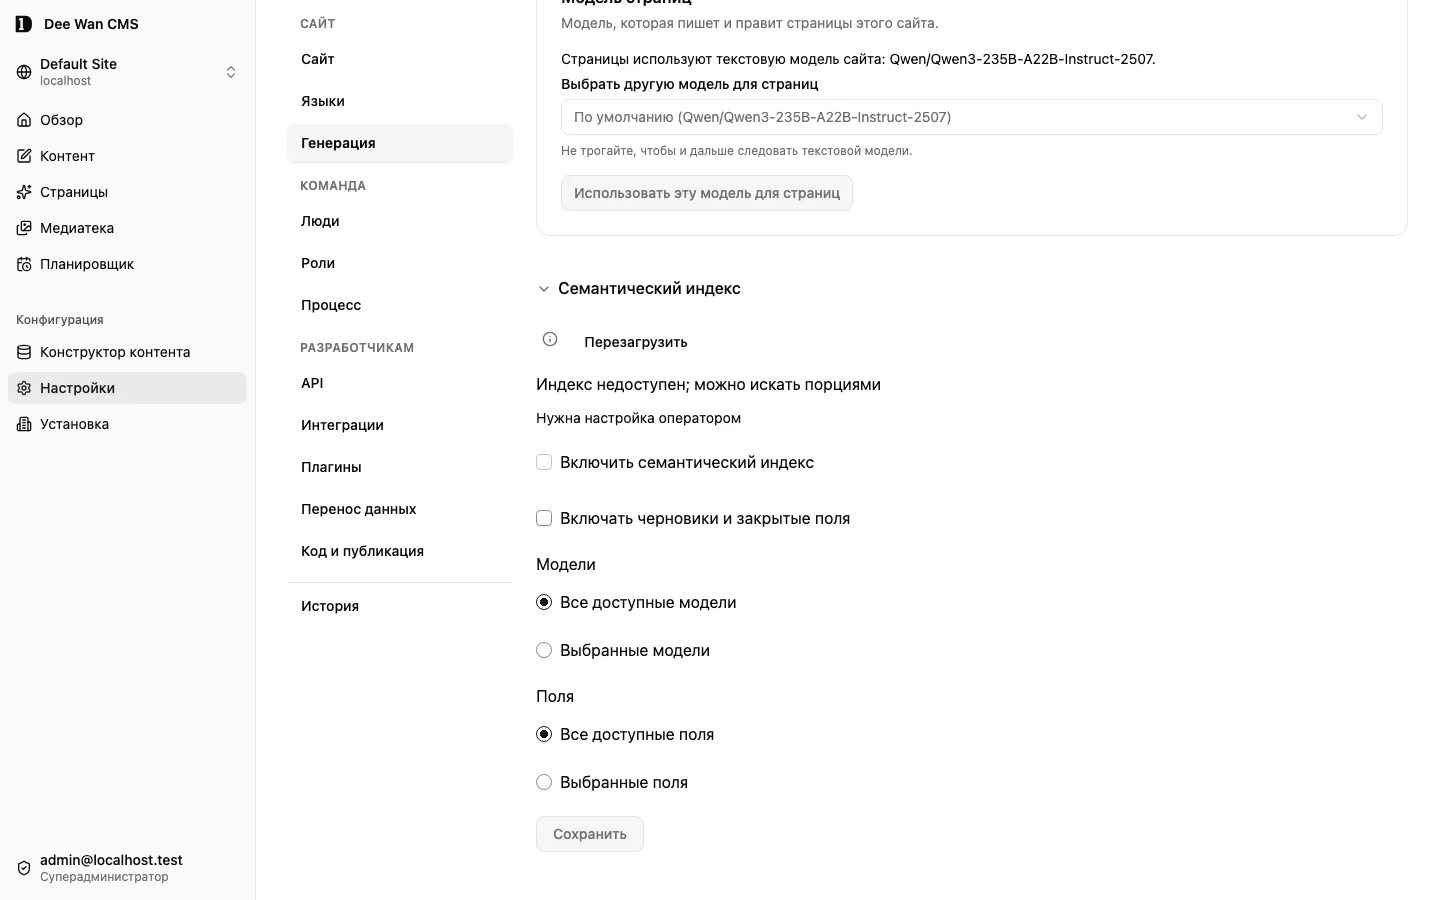
Семантический индекс редактора {#semantic-editorial-index}
Заголовок раздела «Семантический индекс редактора {#semantic-editorial-index}»Этот необязательный индекс помогает искать похожие материалы и дубликаты, подбирать связи и ссылки, выбирать контекст для ИИ. Он не заменяет поиск для посетителей и описанный ниже обход публичного API.
Оператор подключает Cloudflare Vectorize (cosine, 1024 измерения) и Workers AI через
SEMANTIC_INDEX и SEMANTIC_AI. Модель векторизации — @cf/baai/bge-m3. См.
настройку оператором: нужны строковые индексы метаданных
projection, locale, model и работающий фоновый обработчик.
Откройте Настройки → Генерация → Модели → Семантический индекс. Для сохранения нужны
site:settings и ai:generate. Включите индекс, выберите доступные модели и при необходимости
укажите ключи полей через запятую. По умолчанию индексируется опубликованный публичный текст.
Опция Включать черновики и закрытые поля расширяет охват только на текст, который настроивший
индекс пользователь может читать сейчас. Текст отправляется в Workers AI; Vectorize хранит векторы,
идентификаторы и хеши, а не исходные фрагменты. Запросы и пакеты векторизации расходуют квоту ИИ
сайта; также действует тариф провайдера.
Сохранение прежних настроек не пересоздаёт индекс. Выберите Все доступные модели или Выбранные модели и отметьте хотя бы одну модель. В режиме Выбранные поля укажите ключи полей; пустой список выбранных моделей или полей сохранить нельзя.
Изменения и удаления попадают в очередь. Неизменённые поля используют готовые векторы. Перед показом результатов заново проверяются текущий текст, права на поля, язык, публикация, версия и ограничения выбора связей. Оценка сходства не даёт прав доступа. Данные сайтов разделены пространствами имён.
Семантический индекс готов означает, что очередь обработана и провайдер подтвердил изменения. Индекс обновляется; охват пока неполный предупреждает, что часть материалов ещё не участвует в поиске. При сбое или отсутствии подключения показано Индекс недоступен; можно искать порциями. Кнопка Искать порциями возвращает поиск по 24 записи. Пока охват неполный, отсутствие результатов не означает отсутствия совпадений во всём архиве. Удаление в провайдере остаётся незавершённым, пока не появится служебная отметка, записанная после него, и повторная проверка не подтвердит отсутствие вектора. Последующие записи не мешают этому подтверждению. Выключение индекса останавливает поиск через него и ставит сохранённые векторы в очередь удаления.
Поиск по частям доступен и при готовом индексе. Если запрос выходит за пределы выбранных моделей или использует условия по полям либо иерархию, система автоматически ищет по частям. Фильтр моделей применяется до отбора 100 лучших векторов. Достижение этого предела не означает обновление индекса: сообщение о лучших совпадениях относится к результатам запроса, а статус готовности — к самому индексу. Нажмите Искать по частям, чтобы продолжить поиск за пределами этой выборки.
Статический поиск для сайта, который вы собираете сами
Заголовок раздела «Статический поиск для сайта, который вы собираете сами»Для обычного статического сайта добавьте Pagefind через стандартный процесс зависимостей этого проекта и запускайте закреплённый исполняемый файл после сборки HTML. Команда в сценарии сборки — pagefind --site dist, если dist действительно является каталогом результата. Публикуйте HTML вместе с соответствующими поисковыми файлами. Неудачная сборка не должна заменять последнее успешное развёртывание.
Внешние индексы: замена только после полного обхода
Заголовок раздела «Внешние индексы: замена только после полного обхода»Сервису вроде Typesense или Meilisearch нужна явная семантика удаления. Одних повторных операций upsert недостаточно, чтобы удалить запись, которую удалили, сняли с публикации или вывели из области индексации. Dee Wan не управляет этими клиентами и не отвечает за атомарность их операций с индексом.
Определите полную область как проверенный набор (site, model, locale). Подготовьте новое пустое поколение для всех этих кортежей, обойдите все страницы, проверьте каждый ответ и пишите только в подготовленное поколение. Ключ должен включать сайт, модель, стабильный ID записи и фактическую локаль. Не используйте слаг, который может измениться. На проходе одной локали пропускайте результаты другой локали, возвращённые по fallback. Передавайте курсоры без изменений. Отсутствующие, повторные или противоречивые курсоры, неверные записи, ошибки HTTP, таймауты и ошибки любой области отменяют всю сборку.
Только после завершения всех областей адаптер может атомарно активировать полное поколение либо выполнить равноценно изолированную полную замену. Клиенты не должны видеть промежуточное состояние, в котором удаления и добавления применены лишь частично. Успешное пустое поколение допустимо и удаляет все прежние записи. Если одна область падает, даже после завершения других, старое рабочее поколение остаётся неизменным. Заброшенные подготовленные данные можно удалить, не трогая активные.
При начале подготовки зафиксируйте ревизию активного поколения. При активации нужно атомарно сверить сохранённую ревизию с текущей либо выполнять пересборки последовательно, чтобы более медленный старый обход не перезаписал новый. Потерянное подтверждение активации неоднозначно: адаптер должен выяснить, активно ли это поколение. discard никогда не должен удалять активные данные. Одной записи нескольких ключей или переключения указателя в хранилище с отложенной согласованностью недостаточно, чтобы обеспечить этот контракт.
Исполняемый пример адаптера
Заголовок раздела «Исполняемый пример адаптера»Подготовительный обходчик без зависимостей экспортирует rebuildSearch({ scopes, readPage, stage, maxPages, maxDocuments }). Сам он не вызывает провайдеров. Передайте следующие операции адаптера:
| Операция | Обязательное поведение |
|---|---|
readPage(scope, cursor) |
Ограничить время запроса и проверить HTTP-успех. Вернуть {data, page} публичного API. В page находятся boolean has_more и nullable next_cursor. |
stage.begin(scopes) |
Выделить изолированное пустое поколение и сохранить рабочую ревизию. Не очищать и не изменять рабочий индекс. |
stage.write(generation, batch) |
Писать только в это поколение. Отклонять неудачные и частичные записи. Каждый элемент имеет составной key, scope и исходный item. Поисковую проекцию определяет адаптер. |
stage.activate(generation) |
Атомарно опубликовать полное поколение с защитой от записи устаревшим процессом. Если подтверждение неоднозначно, проверять состояние по идентификатору поколения. |
stage.discard(generation) |
Удалять только неактивные подготовленные данные. Никогда не очищать текущее рабочее поколение, в том числе после неоднозначного ответа активации. |
Пример ограничивает число страниц на область и общее число принятых документов. Учётные данные провайдера, настройка индекса и извлечение полей намеренно остаются в существующем поисковом адаптере. Целевые проверки исходников покрывают успешное удаление, пустую замену, сбой после готовой области, неверные курсоры, ошибки подготовки и конфликты конкурентной активации. Запуск из репозитория CMS: node --test scripts/search-index.test.mjs.
Свежесть и приёмка
Заголовок раздела «Свежесть и приёмка»Завершённый постраничный обход не доказывает единовременный снимок, пока контент меняется. Для строгого переключения согласуйте паузу публикаций или используйте принятый опубликованный снимок. Иначе укажите предел свежести пересборки и повторите её. Включённый кэш публичного API может задерживать наблюдаемое удаление. Не обещайте мгновенного исчезновения.
Перед использованием в рабочей среде подтвердите, что снятая с публикации запись исчезает после полной пересборки, а неудачный обход сохраняет все прежние области. Корректный пустой результат очищает старые записи, а старый конкурентный обход не может стать рабочим после нового. Токены приватных моделей хранятся в серверных секретах. Поиск должен обеспечивать тот же доступ. Вебхук может запускать пересборку, но сам не является полным индексом. См. исходящий контракт.
Следующий шаг
Заголовок раздела «Следующий шаг»Сообщайте другим системам о публикации контента через исходящие вебхуки.
Стабильная версия ещё не выпущена (pre-MVP)
Коммит исходного кода: e207e63239a627fbd2ae9c414ef7c6eb19fcfe5a (с локальными изменениями)
Дата сборки (UTC): 2026-10-21T09:28:24.214Z
Коммит для обновления: не определён: в рабочей копии есть изменения. Примечания к выпуску